Sistemi AI
Two-Step RAG per knowledge base
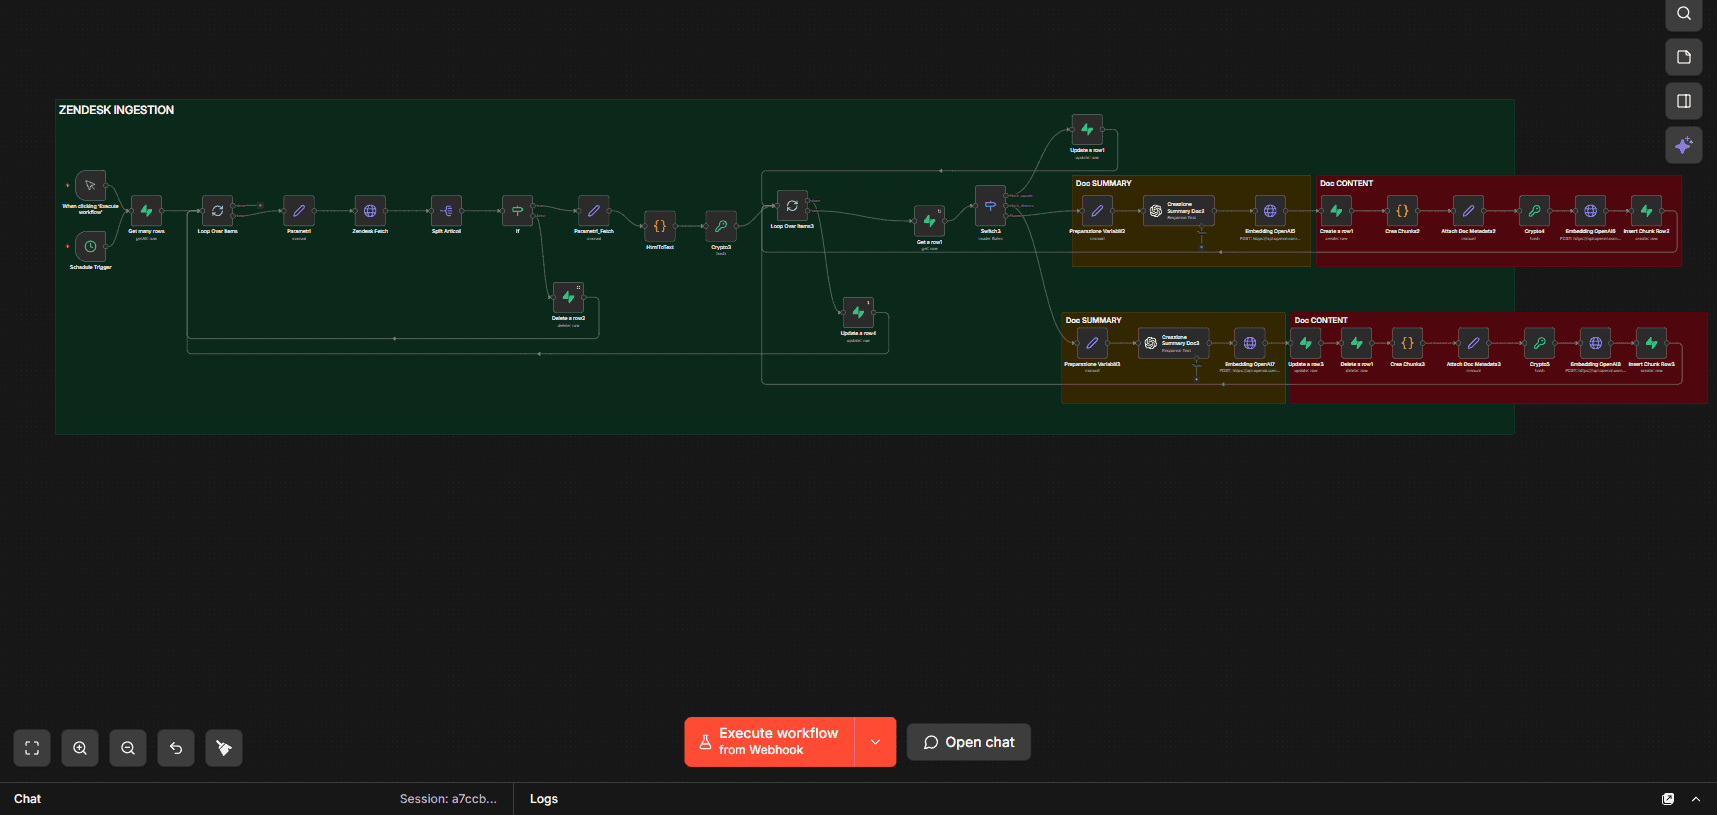
Una knowledge base Zendesk aggiornata con n8n: il retrieval seleziona prima i documenti, poi i passaggi pertinenti per rispondere.
 Apri il workflow ingrandito ↗
Il problema
Recuperare il contesto, non frammenti isolati
Una ricerca vettoriale su tutti i chunk può mescolare passaggi di documenti diversi. Ho costruito un’architettura RAG che prima identifica gli articoli pertinenti e poi cerca i passaggi all’interno di quegli articoli.
La fonte è Zendesk Help Center. Il sistema aggiorna la knowledge base in Supabase PostgreSQL con pgvector, attraverso workflow n8n.
Il sistema
Ingestion e retrieval in due passaggi
La pipeline usa un cursore temporale per rilevare articoli nuovi o aggiornati, esclude le bozze e applica hash a documenti e chunk per evitare duplicazioni.
OpenAI genera embedding dei riassunti e dei singoli chunk. Le funzioni RPC PostgreSQL selezionano prima i documenti e poi i passaggi rilevanti per costruire la risposta.
- Sincronizzazione incrementale da Zendesk
- Esclusione dei contenuti in bozza
- Deduplica a livello di documento e chunk
- Embedding dei riassunti e dei passaggi
- Ricerca vettoriale tramite RPC e orchestrazione n8n
Il risultato
Una knowledge base con un percorso di ricerca esplicito
Il risultato è un sistema di retrieval basato sulla documentazione aziendale, con ingestion e aggiornamento automatizzati. L’architettura può supportare assistenti di customer support, chatbot per help center e copiloti interni.
La ricerca è suddivisa in fasi ispezionabili, invece di affidare la selezione del contesto a una ricerca indistinta su tutti i passaggi. La qualità delle risposte va verificata sul contenuto e sui casi d’uso specifici.